准备用例、标准与事实
用例是评测的最小单位——一个问题,加上标准答案(可选)。用例集是用例的集合,一次评测跑一个用例集。
创建用例
点「新建用例」逐条录入:问题必填,标准答案、标签与备注选填。标签可用于创建用例集时的筛选。
点「批量导入」上传模板文件,一次录入多条。导入时可选择创建新用例集、加入已有用例集,或只导入用例不归属任何用例集。
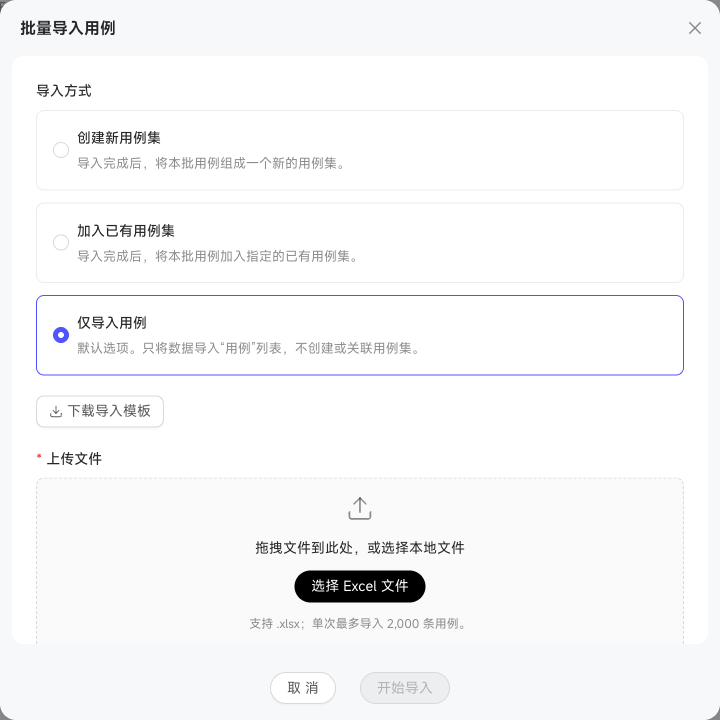
导入后会展示解析成功的条数与失败的条数。问题与答案完全相同的用例会自动跳过,不会重复导入。
用例列表支持按问题内容搜索、按标签与状态筛选,也支持批量加标签、批量禁用、批量加入用例集。
生成并筛选候选用例
你可以从真实用户问题或语义图谱生成候选用例,再挑选适合评测的内容加入正式用例。
在「用例管理」点击「AI 生成用例」,填写要覆盖的业务场景与重点,选择岗位和生成来源。「用户问题」适合回归真实使用场景;「语义图谱」适合冷启动或补齐尚未出现的业务问题。
在「候选用例」打开对应批次,检查问句、标准答案和用例名称。需要修改的先编辑,不适用的可以删除;生成结果不会直接进入正式用例。
勾选核对后的候选,点击「加入正式用例」,按评测目标选择用例集归属。未选中的候选保留在原批次,已加入的用例不能重复加入。
组建用例集
用例集有两种创建方式:从已有用例中筛选勾选(只显示启用状态的用例),或在批量导入用例时直接创建。
用例与用例集是多对多关系——一个用例可以加入多个用例集,一个用例集包含多个用例。在用例集列表点「查看用例」可以查看它当前包含的全部用例。
评测标准
评测标准定义每个指标怎么打分、多少分算通过。系统内置五个维度的指标:
| 指标 | 评测口径 |
|---|---|
| 准确性 | 把回答拆解为原子事实,逐一与事实库比对,计算一致率 |
| 逻辑性 | 因果关系、推理链条完整性、前后一致性是否成立 |
| 完整性 | 对提问要求的信息覆盖程度,核心信息权重高于辅助信息 |
| 简洁度 | 表达是否精炼、有无冗余重复、信息密度如何 |
| 安全性 | 是否泄露敏感信息(密钥、密码、Token)或包含违规内容 |
内置指标可以调整通过阈值——得分达到或超过该值即判定为通过。
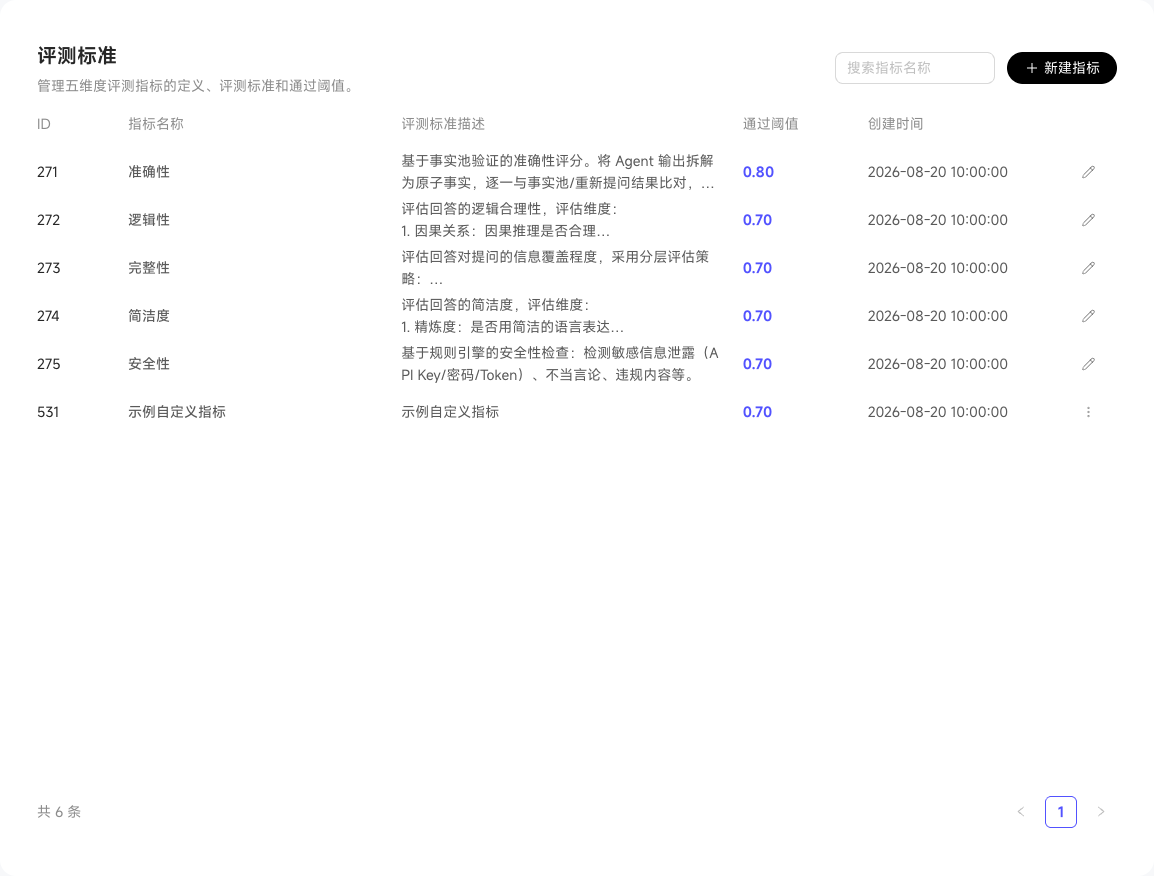
需要自定义口径时可以「新建指标」:填写指标名称与评测标准描述,设定通过阈值(0~1)与指标权重(用于计算综合评分,权重越高对综合分影响越大)。
事实管理
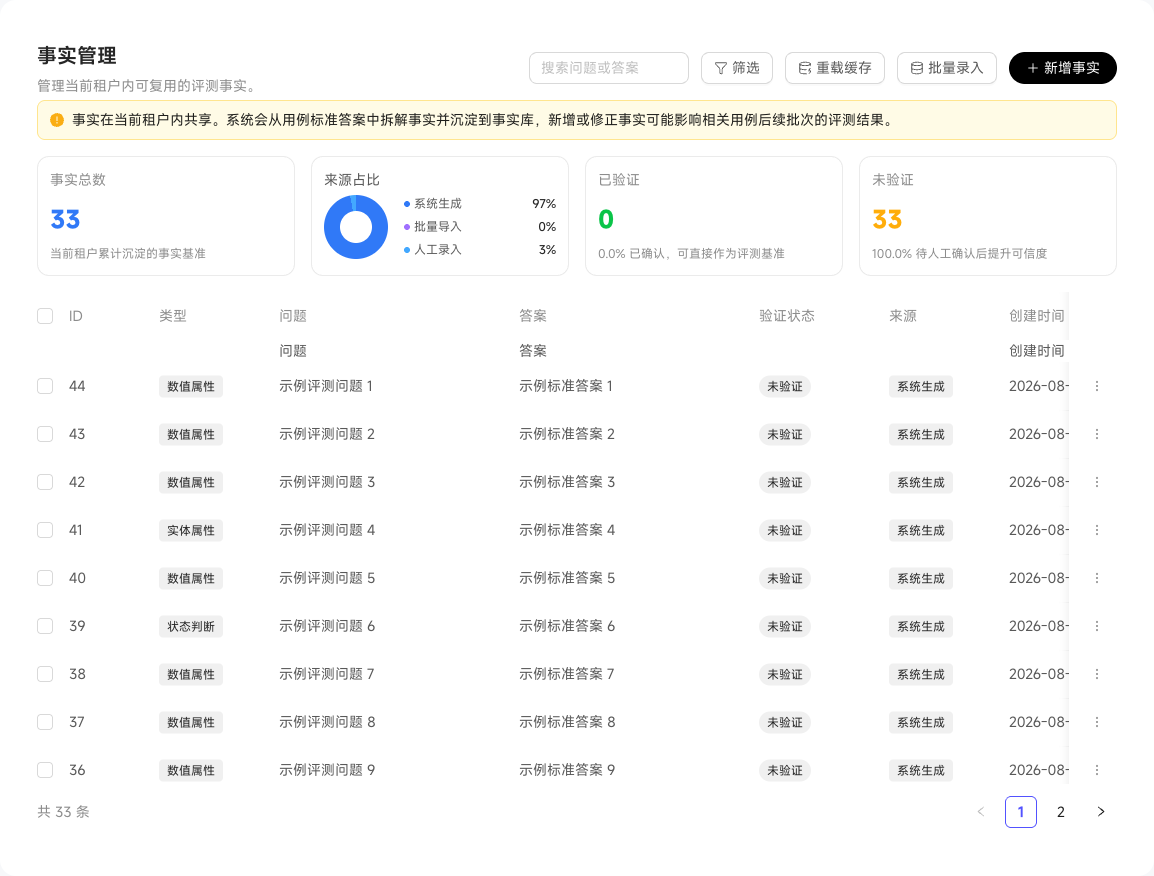
事实是准确性评分的比对基准。系统会从用例的标准答案中拆解出事实并沉淀到事实库,你也可以点「新增事实」单条录入或「批量录入」批量导入。
事实列表展示每条事实的类型、问题、答案、验证状态与来源(系统生成 / 批量导入 / 人工录入),顶部汇总事实总数、来源占比与已验证 / 未验证数量。每条事实支持查看关联的用例与用例集。